
F
licenseNot graded
qualityD
maintenanceEnables parsing and extracting content from WeChat public account articles using browser simulation, supporting multiple output formats (JSON, Markdown, HTML) and media resource extraction.
-

Ein minimalistischer MCP, der es großen Sprachmodellen ermöglicht, Artikel von öffentlichen WeChat-Konten zu lesen.
🎭 Browser-Simulation: Vollständige Simulation einer Browser-Umgebung mittels Playwright
📝 Inhaltsextraktion: Automatische Extraktion von Titel, Autor, Veröffentlichungsdatum und Haupttext
⚡ Kompakte Implementierung: Kernfunktionen mit minimalem Codeaufwand
Related MCP server: WeChat Article Parser
Der Benutzer sendet eine URL und eine Anforderung an das große Sprachmodell
Das Sprachmodell ruft das MCP-Tool auf
Das MCP ruft den Artikelinhalt ab und sendet ihn an das Sprachmodell
Das Sprachmodell gibt basierend auf dem Artikelinhalt eine natürlichsprachliche Antwort aus
Python 3.10+
fastmcp - MCP-Framework
url-md (Rust Single-Binary) - Anti-Scraping + Markdown-Extraktion in einem Schritt
pyyaml - Frontmatter-Parsing
v0.3.0 Upgrade-Hinweis: Die Scraping-Ebene wurde von
agent-browser(4 Unterprozesse + BeautifulSoup-Parsing) auf einen einzelnen Aufruf vonurl-md md <url>vereinfacht.url-mdübernimmt intern das Anti-Scraping, die Extraktion des WeChat-Haupttextes, die Markdown-Konvertierung und die Frontmatter-Generierung. Die Abhängigkeiten wurden reduziert, dascontent-Feld wurde auf Markdown aktualisiert (behält Bildreferenzen / Listen / Überschriftenhierarchien bei). Die MCP-Protokollschnittstelle bleibt unverändert, bestehende Claude/Cursor-Konfigurationen müssen nicht angepasst werden.v0.2.0 Upgrade-Hinweis: Die ursprüngliche Playwright-Lösung wurde durch verschärfte Anti-Scraping-Maßnahmen von WeChat ausgehebelt (issue #3). Die Scraping-Ebene wurde an agent-browser (ein unter Apache-2.0 lizenziertes Rust-Projekt) delegiert. Seit v0.3.0 wurde auf
url-mdmigriert.
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/Bwkyd/url-md/main/install.sh | bash

# Windows (PowerShell)
irm https://raw.githubusercontent.com/Bwkyd/url-md/main/install.ps1 | iex

# 验证
url-md --version
In 6 Sekunden einsatzbereit. 7 MB Single-Binary, keine externen Abhängigkeiten wie Chrome erforderlich (WeChat-Permanent-Links nutzen den schnellen
reqwest-Pfad).
pip install -r requirements.txt{
"mcpServers": {
"weixin-reader": {
"command": "python",
"args": [
"C:/Users/你的用户名/Desktop/wx-mcp/wx-mcp-server/src/server.py"
]
}
}
}Hinweis: Bitte ersetzen Sie die Pfade durch Ihre tatsächlichen Projektpfade.
Direkte Verwendung in Claude:
请帮我总结这篇文章:https://mp.weixin.qq.com/s/nEJhdxGea-KLZA_IGw9R5AClaude ruft automatisch das Tool read_weixin_article auf, um den Artikelinhalt abzurufen und zu analysieren.
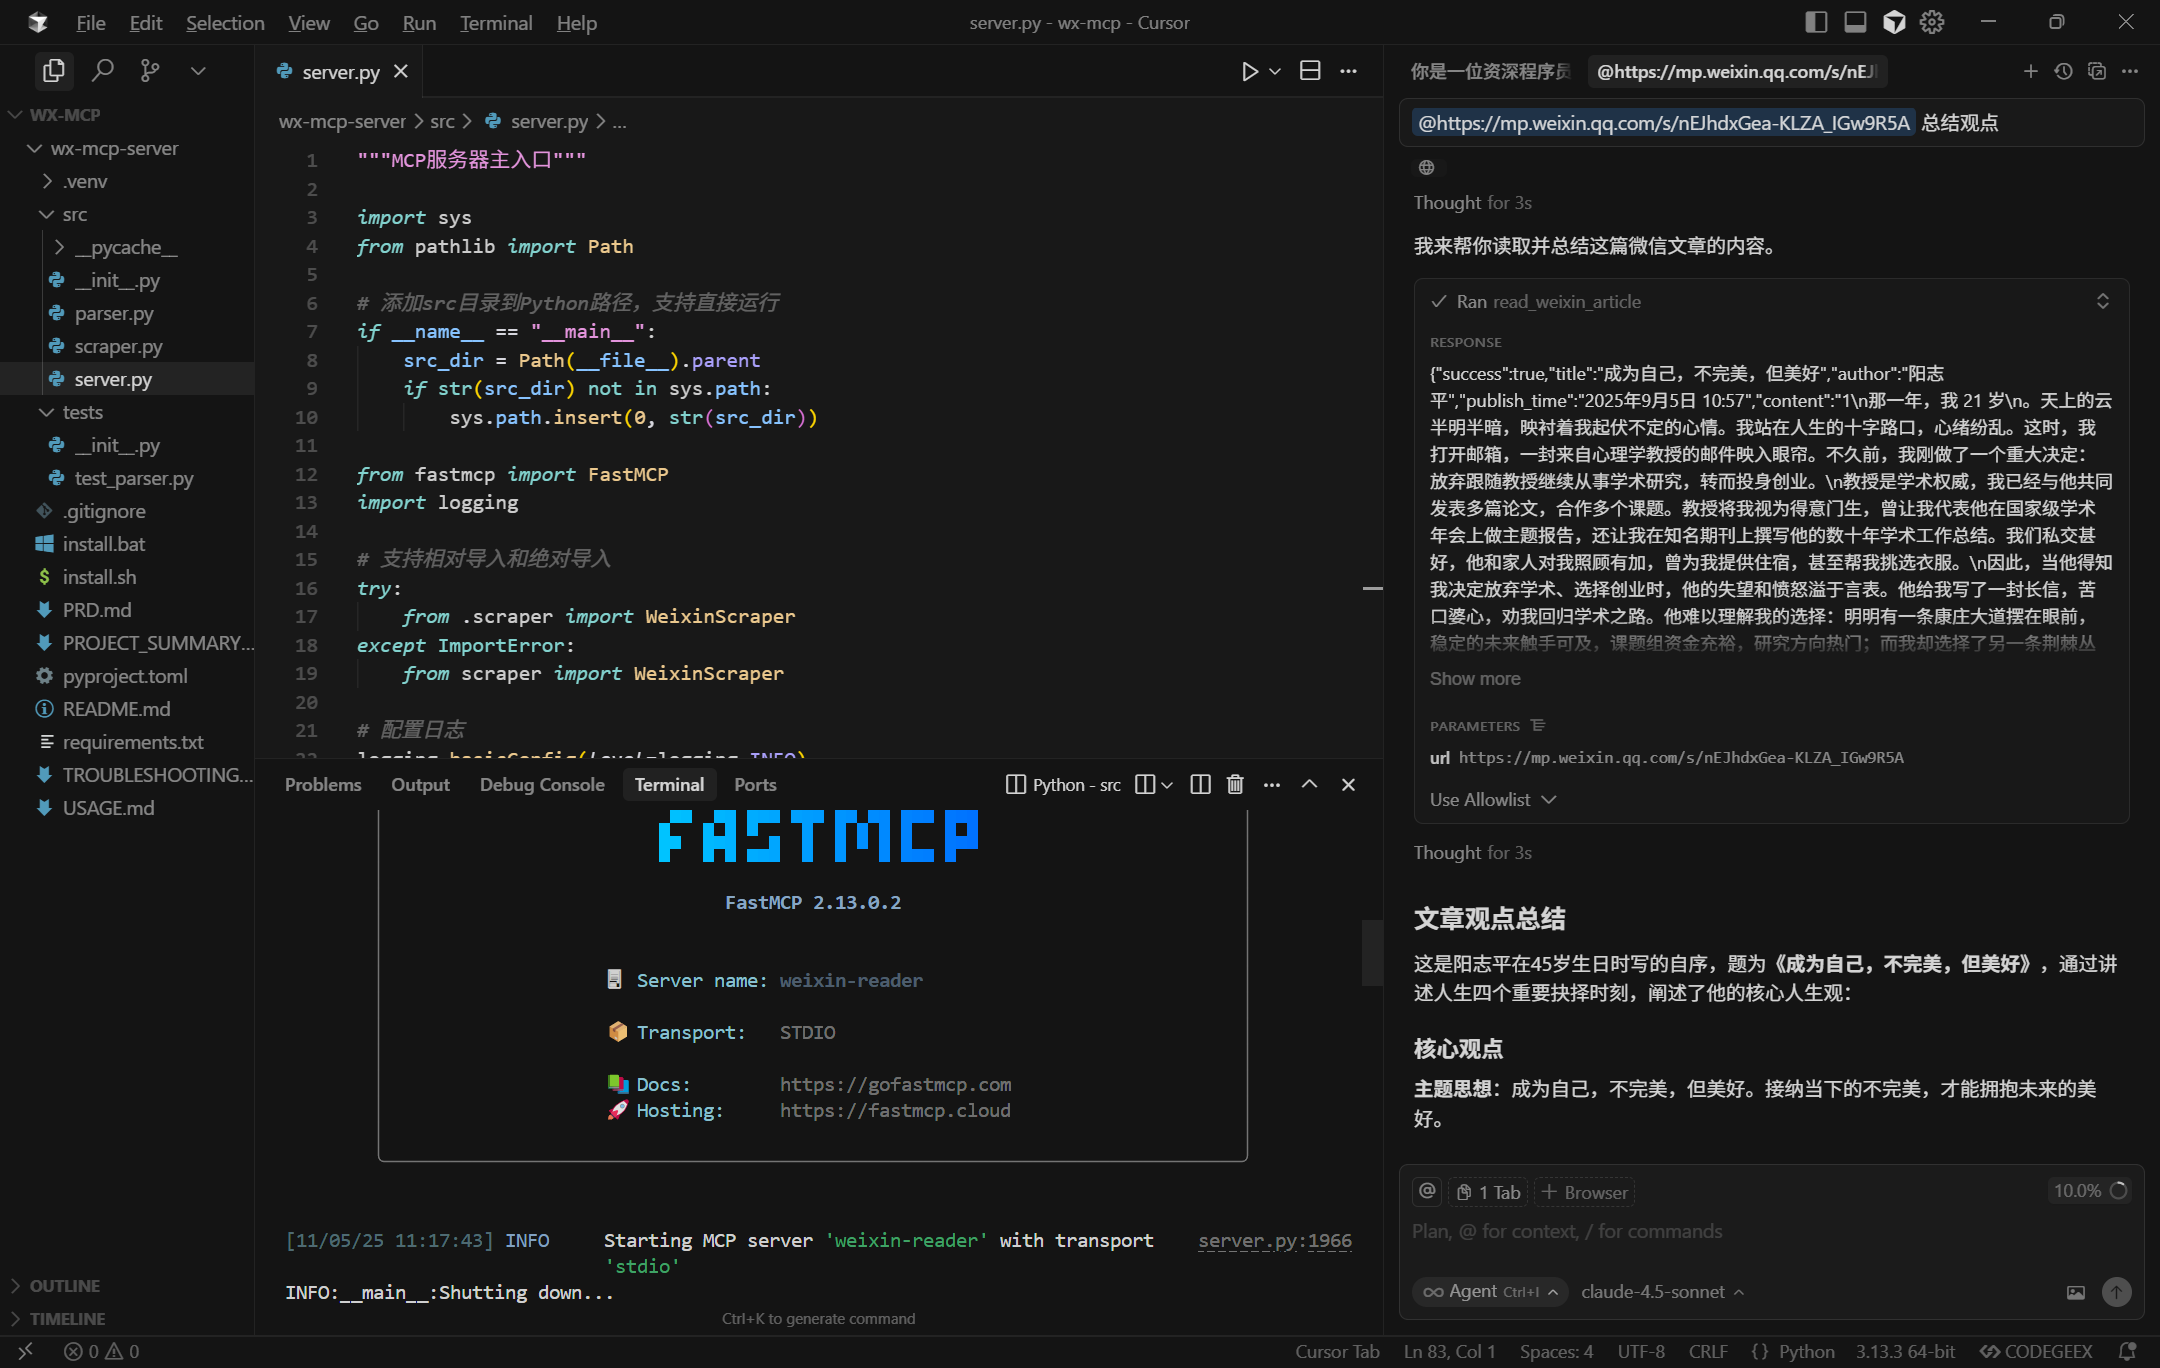
read_weixin_article(url: str)Liest den Inhalt eines Artikels eines öffentlichen WeChat-Kontos.
Parameter:
url: Die URL des WeChat-Artikels, Format: https://mp.weixin.qq.com/s/xxx
Rückgabe:
{
"success": true,
"title": "文章标题",
"author": "作者名",
"publish_time": "2025-11-05",
"content": "# 文章正文\n\n\n\n段落内容...",
"cover_url": "https://mmbiz.qpic.cn/.../wx_fmt=jpeg",
"error": null
}Seit v0.3.0 ist das
content-Feld im Markdown-Format (vor v0.2.0 war es reiner Text). Wenn der nachgelagerte Agent/Prompt bereits auf reinen Text ausgelegt ist, kann die Markdown-Syntax vor der Rückgabe entfernt werden, oder man behält das Markdown bei, da LLMs es nativ besser verstehen können.
⚠️ Nur für den persönlichen Gebrauch zu Lern- und Forschungszwecken
⚠️ Einhaltung der Nutzungsbedingungen der WeChat-Plattform erforderlich
⚠️ Hochfrequentes Scraping wird nicht empfohlen (Empfehlung: Intervall > 2 Sekunden)
⚠️ Nicht für kommerzielle Zwecke verwenden
This server cannot be deployed
AI-powered browser automation — navigate, click, fill forms, and extract data from any website.
Web search, browser automation, scraping, crawling and CAPTCHA solving for AI agents.
Read WeChat public account articles via MCP. 99.89% anti-scraping success, 50-87% token compression.
Read a URL as clean markdown, screenshot a website, url to PDF. Web access for agents, no signup.