
prompt-workbench
by cx0806V
README.md
# prompt-workbench
> **跨 AI 的提示词工作台:选场景 → 被追问几句 → 拿到一段能直接用的提示词。**
> 一个 MCP Server,Claude / Cursor / CodeBuddy / WorkBuddy / Trae 等支持 MCP 的客户端都能用;
> 同一份场景数据还能生成 Skill 包和网页工作台。
[](https://github.com/cx0806V/prompt-workbench/actions/workflows/ci.yml)
[](LICENSE)
[](https://modelcontextprotocol.io)
> **线上服务已上线**:`https://prompt-workbench.cx200809-2022.workers.dev`
> 直接打开 `/health` 可看到 `{"ok":true,"sceneCount":20}`,MCP 端点是 `/mcp`。可以自建(一键部署见下),也可以直接用这个公共实例。
## 怎么用(三种方式,30 秒选一个)
| 你的情况 | 用哪种 | 需要什么 | 花多久 |
| --- | --- | --- | --- |
| 想先在浏览器里试一下 | **网页工作台**(在线,零部署) | 浏览器 | 0 分钟 |
| 想让自己的 AI 客户端直接调用 | **MCP 地址**(见下面「在 AI 客户端里使用」,也可以自己部署一份) | 支持远程 MCP 的客户端 | 1 分钟 |
| 要完全离线,或给 Claude Code 这类客户端装 Skill | **Skill 包** `skills/prompt-workbench/` | 拷一个目录 | 2 分钟 |
> 想自己拥有一份(免费、地址归你)→ 见下面的「一键部署」。
## 在线试用(不用装任何东西)
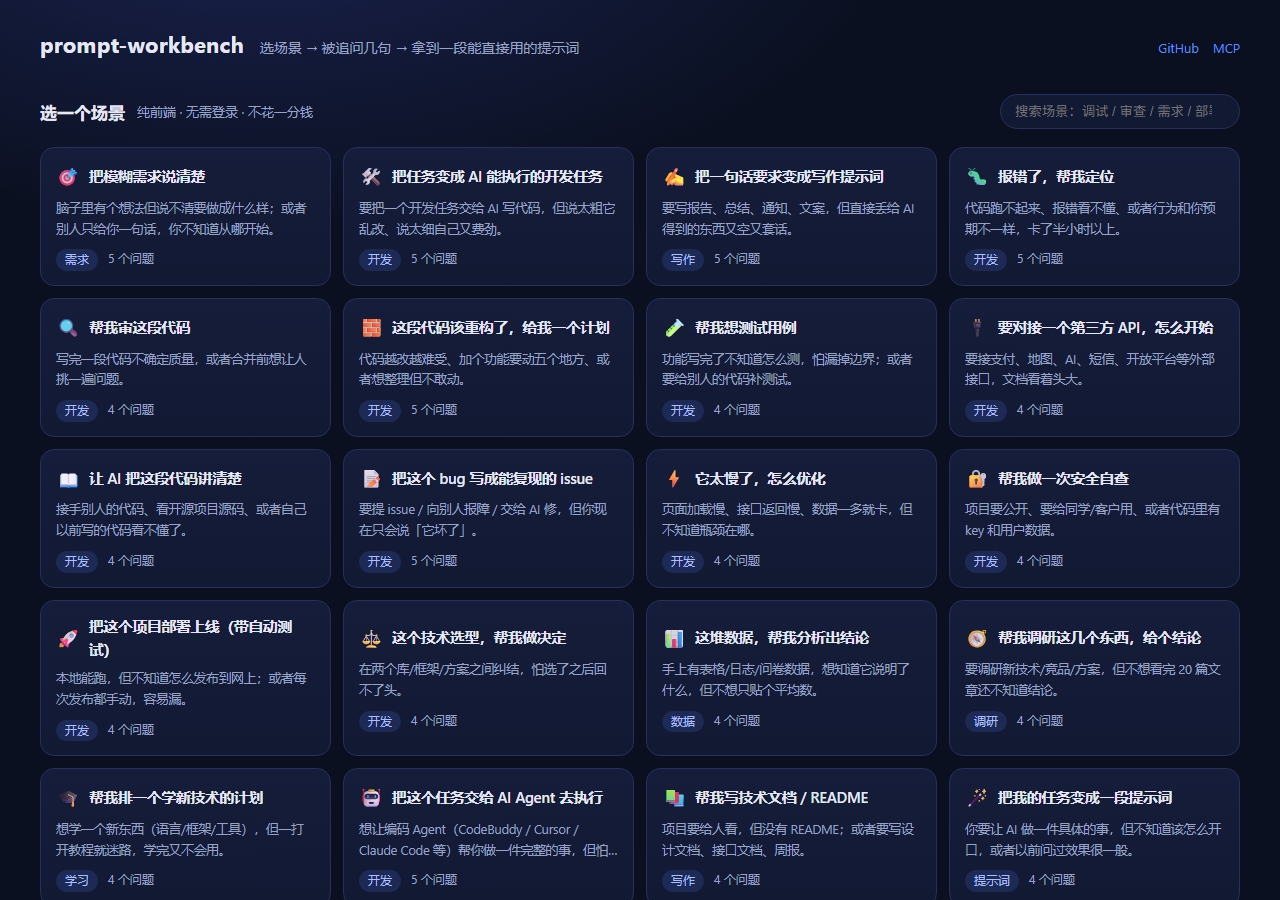
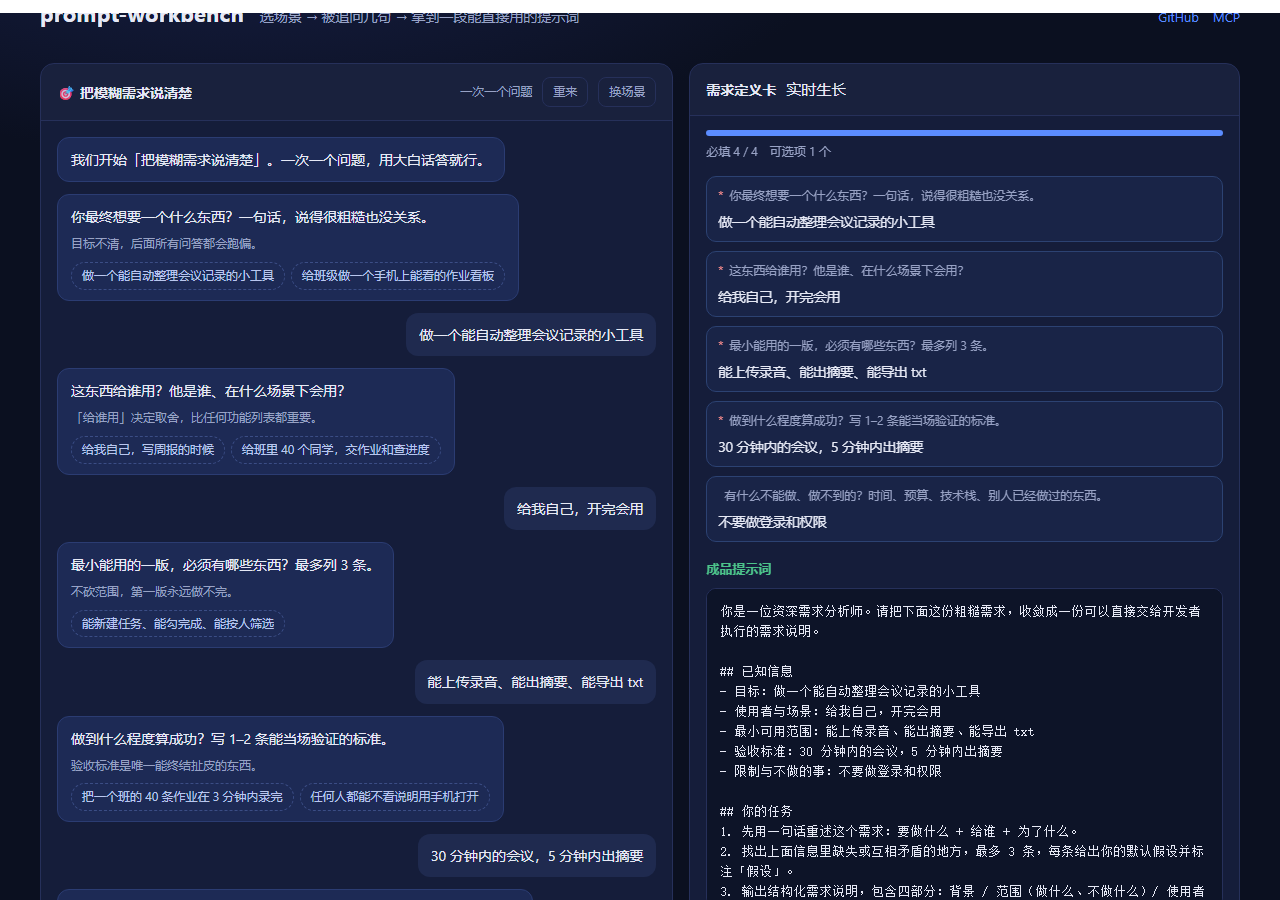
[**打开网页工作台**](https://cx0806v.github.io/prompt-workbench/) —— 选场景 → 被追问几句 → 右侧定义卡实时生长 → 复制成品提示词。纯前端,不登录、不花一分钱。
## 真实反馈与实测修正(2026-10-20 / 10-22)
一位真实用户(非开发者)试用后提出三类问题,都改进了;另有一个自己实测发现的召回 bug:
| 反馈 / 问题 | 改动 |
| --- | --- |
| 「AI 只列缺失和假设,**不给代码**」——用模板让 AI 写 PLC 跑马灯程序,AI 只追问不产出 | **所有成品自动附加「通用交付规则」**:先给一版能直接用的最小版本(缺的参数标假设),再列最多 3 条待确认;只有「改现有仓库」才先确认清单 |
| 「搜不出东西」——用户会搜具体任务词,不是分类词 | 搜索改为**精确包含 + 中文模糊匹配**双路合并 |
| 语音输入 / 朗读 / 数字选择 | **试做后移除**:真实用户反馈「不好用」,已全部回退,只保留纯文字问答 |
| 「给我这个网页加一个导出 CSV 的按钮」→ `recommend_scene` 返回空 | 匹配语料补上每个问题的**示例说法** + 开发类关键词;英文关键词改为大小写不敏感;加回归测试 |
---
## 为什么做这个
大多数人的问题不是「不会写提示词」,是**不知道该问自己哪几句**。
网上的提示词库已经很多了,但它们是「一页页模板」:你要先知道自己缺什么,再去翻对应的那条。
本项目反过来:**先选场景(我要干什么),再让 AI 按固定流程问你 5 个问题,最后把答案渲染成一段成品提示词。**
方法不是凭空来的——是把散落在各家开源项目和提示词工程实践里的做法**蒸馏**成一套场景化流程,
每一处借鉴都写在 [SOURCES.md](SOURCES.md) 里(该文件由场景数据自动生成,不手写)。
## 它解决什么
| 角色 | 得到什么 |
| --- | --- |
| 用 AI 的人 | 不用背模板。选场景 → 回答几个问题 → 复制成品提示词走 |
| AI 客户端 | 4 个标准 MCP 工具,任何支持 MCP 的 AI 都能调用 |
| 开发者 | **新增一个场景 = 加一份数据,不动一行逻辑代码** |
**零依赖、零 API key、零成本**:服务端只做模板渲染,真正的「一步步问」由调用它的那个 AI 完成。
---
## 一键部署(自己的 Cloudflare 账号,免费)
[](https://deploy.workers.cloudflare.com/?url=https://github.com/cx0806V/prompt-workbench)
> 点按钮后:登录 Cloudflare → 授权 → 它会**复制一份仓库到你自己的账号**(不会改动这个仓库),并在你账号下创建一个 Worker。
> 完成后你得到一个自己的地址:`https://<worker>.<你的子域>.workers.dev/mcp`
> 需要:Cloudflare 账号(免费)+ 完成邮箱验证;第一次会让你设一个 `workers.dev` 子域。
> 如果按钮打不开,用下面的 **Fork + GitHub Actions** 方式,或者本地命令行部署。
| 方式 | 适合 | 需要 | 耗时 |
| --- | --- | --- | --- |
| 点上面的 Deploy 按钮 | 大多数人 | Cloudflare 账号 | ~2 分钟 |
| Fork + 配两个 Secret(见「自动部署」) | 想要 push 自动上线的人 | GitHub + Cloudflare | ~5 分钟 |
| 本地 `npm run deploy` | 开发者 / 不想用 CI | Node ≥ 20 + Cloudflare token | ~3 分钟 |
> 不部署也行:直接用线上实例,或者本地 `npm start`(零依赖)。
> **一键部署流程里 Cloudflare 会自动填好两条命令,保持默认即可**:
> 构建命令 `npm run build`(重新生成来源表 / Skill / 网页)、部署指令 `npm run deploy`(= `npx wrangler deploy`)。
> ✅ **2026-10-20 实测通过**:点按钮 → 连 GitHub → 输入任意项目名 → 部署,全程约 24 秒,产物为 `https://<项目名>.<子域>.workers.dev`。
> 部署日志里可能出现两条**警告**(`未能匹配工人姓名` / `workers_dev 不在 wrangler.toml`),**不影响部署**:Worker 名以你填的项目名为准,`workers.dev` 默认开启。
## 快速开始(本地,30 秒)
```bash
npm start
# http://127.0.0.1:8787/ 信息
# http://127.0.0.1:8787/health 健康检查
# http://127.0.0.1:8787/mcp MCP JSON-RPC 端点
```
不需要 `npm install`——本项目零依赖,Node ≥ 20 直接跑。
```bash
npm test # 36 项测试
npm run build:sources # 从场景数据重新生成 SOURCES.md
npm run bundle # 打成单文件 Worker(dist/worker.js)
```
### 手动部署(不需要 wrangler)
如果 Deploy 按钮或 Git 集成不可用,这条命令可以绕过它们,直接把 Worker 传到 Cloudflare:
```powershell
$env:CF_API_TOKEN = "你的令牌" # 权限:Account → Workers Scripts → Edit
$env:CF_ACCOUNT_ID = "你的账户ID"
npm run deploy:api
```
脚本会:打包 → 上传 script → 开启 `workers.dev` 访问,全程无交互。
> 注:`npm run deploy` 是给 Cloudflare 一键部署流程用的标准命令(`npx wrangler deploy`);
> `npm run deploy:api` 是不依赖 wrangler 的备用路径。
### 自动部署(push 即上线)
仓库自带 `.github/workflows/ci.yml`:**push 到 `main` 时先跑测试,测试通过后自动部署**。
只需要在 GitHub 里配两个 Secret(`Settings → Secrets and variables → Actions → New repository secret`):
| Secret | 值 |
| --- | --- |
| `CF_API_TOKEN` | Cloudflare API 令牌(权限:Account → Workers Scripts → Edit) |
| `CF_ACCOUNT_ID` | 你的 Cloudflare 账户 ID |
没配 Secret 时不会报错,只会跳过部署、只跑测试。
## 在 AI 客户端里使用(三步接入)
**适合:已经在自己 AI 客户端里工作、想把「提示词工作台」接进去的人。**
1. **拿到地址**:`https://prompt-workbench.cx200809-2022.workers.dev/mcp`(或者你自己部署的 `<worker>.<子域>.workers.dev/mcp`)
2. **在客户端 MCP 配置里加一条**(见下表)
3. **重启客户端** → 在对话框里说「用 prompt-workbench 帮我审一下这段代码」
### 各客户端速查
| 客户端 | 配置位置 | 写法 |
| --- | --- | --- |
| **WorkBuddy** | `~/.workbuddy/connectors/default/mcp.json` 的 `mcpServers` | `{"type":"streamableHttp","url":".../mcp","timeout":30000}` ✅ 已实测 |
| **Claude Desktop** | `claude_desktop_config.json` | `{"type":"http","url":".../mcp"}` |
| **Cursor** | `~/.cursor/mcp.json` 的 `mcpServers` | `{"type":"http","url":".../mcp"}` |
| **VS Code** | 工作区 `.vscode/mcp.json` 或用户设置 | `{"type":"http","url":".../mcp"}` |
| **CodeBuddy / Trae / Cline / Continue** | 各自的 MCP 设置页 | 选「远程 MCP / Streamable HTTP」,粘贴 URL |
通用写法:
```json
{
"mcpServers": {
"prompt-workbench": {
"type": "http",
"url": "https://prompt-workbench.cx200809-2022.workers.dev/mcp"
}
}
}
```
> ⚠️ `type` 字段名各客户端不同(`http` / `streamableHttp` / `sse`),以各自官方文档为准。
> 只支持 stdio 的老客户端:用 `npx mcp-remote <url>` 做 HTTP→stdio 桥接。
> **DeepSeek 网页版 / App 不支持 MCP**——用 DeepSeek 的人请走「网页生成提示词 → 复制粘贴」,不需要部署。
> 判断标准:客户端支持「远程 MCP / Streamable HTTP」就能直连;只支持本地命令行(stdio)的,需要桥接。
典型对话:
> **你**:帮我写份项目总结报告。
> **AI**:*调用 `recommend_scene`* → 匹配到「写作 / 把一句话要求变成写作提示词」,然后调用 `get_questionnaire` 开始逐个问你。
### WorkBuddy(连接器,客户端内直接用)
WorkBuddy 支持远程 MCP 连接器。把下面这段加进 `~/.workbuddy/connectors/default/mcp.json` 的 `mcpServers` 里,重启 WorkBuddy 就出现在工具列表里——**不装、不注册、不需要 key**,消耗的是用户自己的 WorkBuddy 额度:
```json
{
"mcpServers": {
"prompt-workbench": {
"type": "streamableHttp",
"url": "https://prompt-workbench.cx200809-2022.workers.dev/mcp",
"timeout": 30000
}
}
}
```
之后在 WorkBuddy 里说「帮我审一下这段代码」,它会调用 `recommend_scene` → `get_questionnaire` → `render_prompt`,逐个问题问你。
⚠️ 各客户端版本的连接器格式可能不同,以官方文档为准。
## 作为 Skill 安装(离线兜底,不需要 MCP)
仓库里的 [`skills/prompt-workbench/`](skills/prompt-workbench) 是**从同一份场景数据自动生成**的 Skill 包(23 个文件 / 33 KB):
```
skills/prompt-workbench/
├─ SKILL.md # 流程与规则(渐进式披露的入口)
└─ references/
├─ scenes-index.md # 20 个场景索引
├─ sources.md # 来源与致谢
└─ scenes/<id>.md # 每个场景的问题清单 + 模板 + 来源
```
**装进 Claude Code / CodeBuddy**(把整个目录拷到 skills 目录):
```powershell
# Windows
Copy-Item -Recurse skills\prompt-workbench "$env:USERPROFILE\.claude\skills\"
```
```bash
# macOS / Linux
cp -r skills/prompt-workbench ~/.claude/skills/
```
装好后在对话里说「帮我把这个需求说清楚」,Skill 会按场景逐个提问并渲染提示词。
**WorkBuddy / 其他平台**:把 `SKILL.md` 作为技能说明、`references/` 作为知识文件提交到对应平台。⚠️ 各平台技能格式与审核规则不同,以官方文档为准。
**生成方式(不要手改)**:
```bash
npm run build:skills
```
CI 会重新生成并比对:**技能包和场景数据不一致就会失败**,所以不存在「场景改了、Skill 忘了更新」的漂移。
## 工具
| 工具 | 作用 |
| --- | --- |
| `list_scenes` | 列出场景,可按分类/关键词过滤 |
| `recommend_scene` | 只给一句话时,推荐最匹配的 1–3 个场景 |
| `get_questionnaire` | 取某场景的提问清单(**逐个问,不要一次全抛**) |
| `render_prompt` | 把槽位答案渲染成成品提示词,返回 `prompt` / `missing` / `warnings` / `complete` |
## 场景(20 个)
| 场景 | 分类 | 解决的问题 |
| --- | --- | --- |
| 🎯 把模糊需求说清楚 | 需求 | 想法说不清、需求只有一句话 |
| 🛠️ 把任务变成 AI 能执行的开发任务 | 开发 | 交给 AI 写代码时边界不清、乱改 |
| 🐛 报错了,帮我定位 | 开发 | 卡在报错上,不知道从哪查 |
| 🔍 帮我审这段代码 | 开发 | 写完不确定质量,合并前想被挑一遍 |
| 🧱 这段代码该重构了,给个计划 | 开发 | 越改越难受,但不敢动 |
| 🧪 帮我想测试用例 | 开发 | 功能写完了不知道测什么、怕漏边界 |
| 🔌 要对接第三方 API,怎么开始 | 开发 | 文档看着头大,key 和失败处理都没想清 |
| 📖 让 AI 把这段代码讲清楚 | 开发 | 看不懂别人的代码 / 自己的旧代码 |
| 📝 把这个 bug 写成能复现的 issue | 开发 | 只会说「它坏了」,别人没法复现 |
| ⚡ 它太慢了,怎么优化 | 开发 | 不知道瓶颈在哪,怕瞎改 |
| 🔐 帮我做一次安全自查 | 开发 | 要公开/给别人用,怕泄露 key 和数据 |
| 🚀 部署上线(带自动测试) | 开发 | 本地能跑,不知道怎么发布、每次手动易漏 |
| ⚖️ 技术选型,帮我做决定 | 开发 | 两个方案纠结,怕回不了头 |
| 🤖 把任务交给 AI Agent 执行 | 开发 | 怕 Agent 乱改文件 |
| 📊 这堆数据,帮我分析出结论 | 数据 | 有表格但不知道说明什么 |
| 🧭 调研这几个东西,给个结论 | 调研 | 看不完 20 篇文章还不知道结论 |
| 🎓 帮我排一个学新技术的计划 | 学习 | 一打开教程就迷路,学完不会用 |
| 📚 帮我写技术文档 / README | 写作 | 项目要给人看但没有文档 |
| ✍️ 把一句话要求变成写作提示词 | 写作 | 直接丢给 AI,写出来又空又套话 |
| 🪄 把我的任务变成一段提示词 | 提示词 | 不知道怎么开口,或者以前效果一般 |
> **新增场景只需要加一份数据文件**,见下。
## 加一个场景(约 30 行,0 行逻辑)
1. 在 `data/scenes/` 新建 `your-scene.js`:导出包含 `id / title / category / whenToUse / keywords / questions / template / sources` 的对象;
2. 在 `data/scenes/index.js` 里 import 并加进数组;
3. `npm run build` —— 一条命令重新生成 `SOURCES.md`、Skill 包、网页(三处都由场景数据生成);
4. `npm test` —— 测试会自动校验:id 合法、`questions[].key` 在模板里有 `{{占位符}}`、`sources` 非空。
```js
export default {
id: 'your-scene',
title: '场景名',
category: '分类',
whenToUse: '什么时候用',
keywords: ['关键词'],
questions: [{ key: 'goal', ask: '你的问题文案', required: true, examples: ['示例'] }],
template: '你是……\n## 已知信息\n- 目标:{{goal}}',
sources: [{ repo: '借鉴的项目', what: '借鉴了什么', how: '我改了什么' }],
};
```
## 架构:一份核心,多个壳
```
data/scenes/*.js 场景库(数据) ← 蒸馏产物,唯一内容源
src/core.js 纯函数引擎(无平台 API) ← 校验 / 匹配 / 渲染,可单测
src/mcp.js MCP 协议层(零依赖)
src/worker.js Cloudflare Worker 壳
bin/serve.mjs 本地 Node 壳(同一套 handler)
scripts/ 从数据生成 SOURCES.md 等
tests/ 零依赖测试(node --test)
```
**三条硬规则(防屎山):**
1. **场景 = 数据,不是代码。** 新增场景 0 行 UI/逻辑代码。
2. **`core.js` 不碰平台 API。** 因此能单测、能被三个壳复用。
3. **来源由数据生成。** `sources` 是每个场景的必填字段,`SOURCES.md` 从它生成,不能手改。
## 路线图
- [x] 核心引擎 + MCP Server(零依赖)
- [x] **20 个场景** + 36 项测试(场景数据改动会被测试自动校验)
- [x] 来源自动生成(`SOURCES.md`)
- [x] Skill 包自动生成(同一份数据 → Claude / WorkBuddy Skill)
- [x] 网页工作台(左侧对话 + 右侧定义卡实时生长)
- [x] WorkBuddy 远程 MCP 连接器实测通过;其他客户端按官方格式接入
- [ ] MCP 官方注册表上架(preview 阶段)
## 来源与致谢
见 **[SOURCES.md](SOURCES.md)**。借鉴的是思路与结构,不是代码;各项目代码许可证以各自仓库为准。
## License
[MIT](LICENSE)